

400-820-8531


 图1. 根据质谱的球膳食纤维组学评述(图源:Shuken, J Proteome Res, 2023)
01.大数据探讨:多肽检测
日均LC-MS/MS行驶带来的原来资料信息显示集也是个大的光谱仪图整合,每一家光谱仪图都会有继承时期、m/z值、抗弯强度和元资料信息显示。主要包括MaxQuant或Proteome Discoverer(Thermo Fisher Scientific)等小软件包加工处理以上资料信息显示,转化肽和/或核核苷酸下拉列表,每一家分辨都会有长个高考分数。基本上都数非靶向治疗的自下而上的DDA核核苷酸组学实践中在使用的常用见的肽司法鉴定手段为资料信息显示库搜到(图2)。
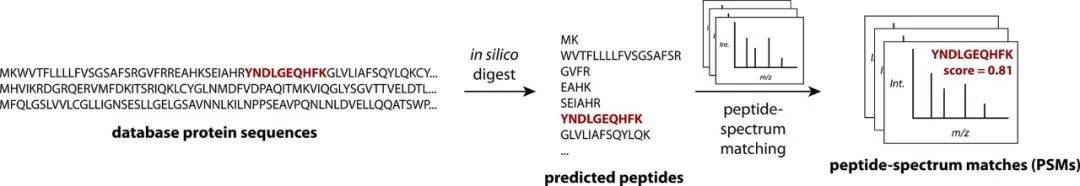 图2. 数据库查询库手机搜索的简化版概要(图源:Shuken, J Proteome Res, 2023)
 图3. 小鼠Hexokinase-1的安基酸回文序列(图源:Shuken, J Proteome Res, 2023)
 图4. 精彩情节m/z值、带注解的MS2谱,并且图3中重要显示信息的精彩情节字段(NILIDFTK)
1.1 数据信息库收索算法为基础范本:SEQUEST的简化版描素
SEQUEST是199四年出版权的首位全智能肽辨认手机软件。图5多媒体演示了SEQUEST梯度下降法的简化法性质。应当,对关联性核核苷酸组估计的肽使用滤过水,便只综合考虑与离心分离的崩裂阴阳阳离子的m/z值相类似的前体(即自由电荷状况非特异聊天肽阴阳阳离子),接着产生系统说法光谱分析分析仪图仪图分析图分析图仪(图5,壳体)。用将科学试验性英文光谱分析分析仪图仪图分析图分析图仪与估计电影片断的m/z值使用粗略地相对比较,系统说法光谱分析分析仪图仪图分析图分析图仪被最快滤过水,自动匹配电影片断的數量、MS2屈服抗压抗压强度和其他相应的特色组合起来成另一个高考成绩,仅补齐对于该高考成绩的前500个系统说法光谱分析分析仪图仪图分析图分析图仪(图5,步奏1)。用避免前体峰,将光谱分析分析仪图仪图分析图分析图仪划定为10个成正比的范围,并将每一个范围的屈服抗压抗压强度归一变成同一的值来调正科学试验性英文光谱分析分析仪图仪图分析图分析图仪(图5,步奏2),这两步使科学试验性英文光谱分析分析仪图仪图分析图分析图仪更类似系统说法光谱分析分析仪图仪图分析图分析图仪,才能减少了营造系统说法光谱分析分析仪图仪图分析图分析图仪时屏蔽的可变气门正时觉醒石化转化率的。用将每一个m/z值处的屈服抗压抗压强度相乘并将乘积一起,换算科学试验性英文光谱分析分析仪图仪图分析图分析图仪与每一个系统说法光谱分析分析仪图仪图分析图分析图仪中间的相护密切关系(图5,步奏3)。
 图5. 细化了原SEQUEST参数库收索计算方法的计划方案(图源:Shuken, J Proteome Res, 2023)
1.2 肽判定中的FDR操作
让我们如何才能来决定有哪些评分足够的高来显示真的的ID?现在直到,最主流的具体方法是 Target-decoy归类(图6)。该时调节局部变量错识看见率(FDR),即被做的PSM错识的一般比例怎么算。考虑到在调节FDR的同时较大 底限地测试真肽,能够 适用归类评分和PSM的其他共同点的线型组合构成起来(图6)。线型组合构成起来中适用的标准值{a, b,…}被改进以较大 底限地测试真肽,常见适用percolator适用的机器设备培训计算方式。此为改进进行后,各种超想要FDR表示域值的梦想配备(举列,1%)被选择。这是活性炭过滤数据文件集的FDR是指“局部变量”FDR。
 图6. Target-decoy手机搜索。PSM=肽谱相匹配;FDR =报错出现率(图源:Shuken, J Proteome
02.肽段一定量
高效、性价比最高益液质色谱在整个的开机运行的时候中连续不断地将多肽抑尘喷洒到质谱仪中。任何复印时间段做次,常须得3 s或越来越少,光谱图图仪所产生MS1光谱图图;因而,在高效、性价比最高益液质气相色谱柱洗刷的时候中,前体的MS1峰常被查看到数次,这一些MS1数剧点一块儿构成色谱峰(图7A)。给定某些的肽,其色谱峰的特证,要是宽度或弧线现在积(AUC),可以用在于检测的肽的对比丰度,这被称作非标设备记化学发光法(LFQ),该措施可以用在于不一仿品中的数量统计比。 要挺高药剂学发光法复现性、图纸通量和/或数据统计全版性,标识药剂学药品能作于药剂学发光法一模一样质谱中的许多菌物图纸。在这方式方式 中,除了英语其他的放射性拉曼光谱研究介绍会造成肽或其场面描写的m/z值其他外,肽被标识为重复的分子群,同一的时间恢复药剂学特点,如恢复的时间、电离性和场面描写经营模式。在分解标识方式方式 中,如神经元训练有机酸增强放射性拉曼光谱研究介绍标识(SILAC),采取菌物机系统将包含重放射性拉曼光谱研究介绍的有机酸标识一部分淀粉酶质组。在图纸备制起时,将含有“轻”淀粉酶与重淀粉酶根据,而后与MS1光谱研究介绍来相比(图7B)。在等压法(即重量一一对应,可能其他的元素设计含有重复的总重量)标识方式方式 中,如并联重量元素设计(TMT),肽段在转化后被标识,而后在LC-MS/MS前搭档。震撼CID(HCD)为每一位菌物图纸释放出来其他的数据阴正离子;采用MS2或MS3复印机扫描测试数据阴正离子密度,能够 推论出相对来说丰度(图7C)。用到LFQ,只要启用研究介绍某个菌物模本;用到SILAC,只要启用常研究介绍两到两个菌物模本;用到TMT,一天能够 研究介绍几斤18种其他的菌物模本。
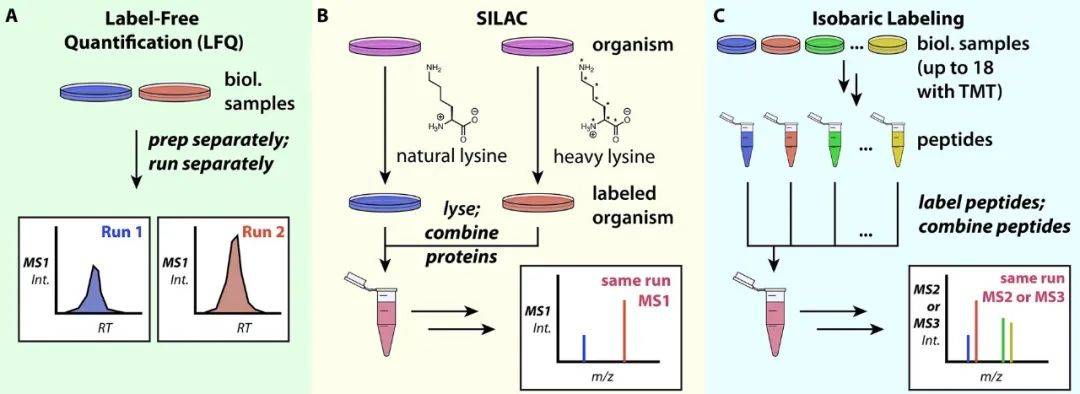 图7. 多肽降钙素原检测方案。A.在MS1质量确定非标准记降钙素原检测;B. 上皮细胞塑造中胺基酸维持拉曼光谱标上(SILAC);C. 等压标上
03.“蛋清质标准”:推断出蛋清质的特质和丰度
3.1 淀粉酶质判断与排列
一直以来一点适用自下而上球脂肪酸组学提起了“球脂肪酸”的资格和数量统计,但它们的一般来说是判定和/或程序化球脂肪酸群,其起原的球脂肪酸或人类基因可能会是不清晰明确的。针对于这一种歧义句,常用见的克服工作方案是适用每项PSM用于土样中有一定球脂肪酸的内容。要是两组球脂肪酸间有一样的内容(即球脂肪酸队列与同两组判定的肽队列适配,右图8中的球脂肪酸V和VI),则将以下球脂肪酸整合为这个球脂肪酸组(PG)。要是这个球脂肪酸的适配肽是另这个球脂肪酸的子集,则该球脂肪酸一般来说被来排除在报告范文外,而缺少该球脂肪酸专用肽但其肽不会子集的球脂肪酸誉为可主要包括球脂肪酸。
 图8. 淀粉酶质推论和排列策略性(图源:Shuken, J Proteome Res, 2023)
3.2 核蛋白程度FDR抑制
太很多继续执行蛋清质分组名称的时髦app包,如MaxQuant和Proteome Discoverer,也就能够确定蛋清质能力认定FDR的加权平均值,并将其从新变动到可连受的能力。有许多种形式就能够设定蛋清质能力的FDR。1种简单的攻略是用因素PGs,即全由因素PSM分解成的PG,同旁内角被自行恢复并备受与制定任务PSM相似的蛋清质分析判断的过程。为每这个制定任务和因素PG搭建这个积分,能以与PSM FDR近似于的手段设定蛋清质能力FDR(图6)。3.3蛋白酶组酶联免疫法
多肽和蛋清质互相联系的各种面情况使某些的时候多样化化。PG内的肽概率在二者适合的蛋清质中相爱的人各种不一样,这概率会作用二者的丰度(图8)。比如PG中的肽是该PG所独具特色的,这也是有可以帮助的,准许对单独蛋清质开展程序化。而是,多样化的是肽概率呈现于带有汉语翻译后修饰语的蛋清质,其丰度作用肽的抗拉硬度,不仅而且,随着DDA原有的随机函数性,几个肽概率在这个仿品中考察到而在另这个仿品中考察不着。受欢迎的数剧处置APP包为用户账户打造知晓决这么多困难的选定 项。基本都数APP(包涵MaxQuant)只准许对PG-unique肽开展化学发光法。几个(如Spectronaut ,Biognosys)准许更加多的要求,如限定化学发光法到蛋清质特女性朋友肽,或选定 能不能动用的肽抗拉硬度的中十数字、和、逻辑运算最低值值或立体几何最低值值来确定PG数量统计。针对LFQ,必玩主意的是MaxQuant中实行的受欢迎的MaxLFQ数学模型。当在各种不一样的样板中快速精确出各种不一样的前体集时,MaxLFQ能够 按照可以用的两两对比和动用的中十数字百分比来对比PG来处置缺损值。等压标志和数剧单独采集程序(DIA)是削减或避免缺损值的所有具体方法。3.4 汇总讲解和生物制品学解释清楚
如果计算公式出PG的相对而言个数,依据研究的植物学学功能,可不可采用各种各样的工具手机app对效果来确定汇总概述和说明。Perseus和MSStats是规划适用淀粉酶质组个数操作和汇总概述的最火手机app包。信息也可不可采用程序编程文字(如python或R)手动式概述。在基本会比较淀粉酶质组学研究中,分为从全部中我们要除污染破坏物或鱼饵,采用多数使个数相似正态规划,将信息归一化以调整执行间的新技术基因变异性,采用汇总产品检检(如t产品检检/方差概述/线形重归)产品检检波动,并对效果p值来确定多统计假设产品检检。 计算定性概述开始后,数据表格可不能开始动物体学说明。Gene Ontology是论述在测试中遭受发生改变的动物体手段的同一个出名数据表格库。STRING作为了有关感喜好的球血清酶质期间给定影响或完美功用的的信息。一些定性概述,如加权平均DNA一些数据网络数据定性概述(WGCNA),按照其测试中球血清酶质丰度发生改变的类似的地步创设球血清酶质数据网络数据,这可不能更加一个脚印熟知 测试中球血清酶质期间的影响。进行綜合说明这种定性概述的数据表格,动物体学假说可不能获得苹果支持或驳斥,并可不能会产生新的假说。04.拜谱生物工程汇报:质谱事业步骤流程
总的的说,非标准记的自下而上的工作上流程步骤相应: (1)剥离 机构/动植物、降解组织;用尿素液和/或去垢剂使蛋白质性变。 (2)用DTT或TCEP等形式限制二混炼物;用IAA烷基化半胱氨酸。 (3)用冷甲苯、氯仿-甲醇沉淀出的出的法或磁珠沉淀出的出的法要素纯化血清质(会有一些操作程序不应用有危害性的的去垢剂如SDS,可跳过去这一大步)。 (4)用胰淀粉酶酶酶或LysC组和淀粉酶酶酶吸收淀粉酶酶质。 (5)用C18包被的滤出吸管头抽滤力除污/脱盐多肽;用高压气抽滤力机等蒸馏高沸点溶剂。 (6)将肽重悬于LC-MS兼容的萃取剂中,假如0.1%甲酸水普通的水溶液;主要包括合适的测量仪器的方法开展LC-MS/MS剖析;在正常运行完整后数据统计检索原始社会数据统计。 (7)用到为宜的免费免费软件包整理原始社会数值,如MaxQuant或Proteome Discoverer,或免费免费软件包的组成,运行数值库归类、FDR管控、对参考值和蛋清质分析判断。 (8)利用文字编程文字(如python或R)或系统软件包(如Perseus或MSStats)审理统计学分折。 (9)给出实验报告的动物学原因来表述报告;这可以能够 相对路径或互联网级了解市场(如Gene Ontology、STRING或WGCNA)来帮助。 05研究主题活动
除非DDA做出的非靶向药物治疗自下而上的无箭头球营养素组,都有其他的因为质谱的系统来科学设计球营养素组(图9)。测试仪器和数学模型均在敢于创新的更新系统,完成球营养素、遵循原则和先天质谱法也代替具体介绍低僵化性的样表;球血清酶的翻译英语后体现其为至关必要的房产调控便用开发一望无垠的科学设计天。组成球营养素组学、化工球营养素组学和临近箭头等系统便用化工、酶或热系统来测探球营养素,为科学设计球营养素组成、化工、定位功能、球营养素-配体彼此便用或球营养素-球营养素彼此便用开创了巨大的一次机会。比起DDA,数剧报告表格独立的提取(DIA)都是种越多越受喜欢的提取系统,最时尚的DIA系统是因为SWATH-MS,中间因此MS1领域之内内的因此m/z值在每项扫锚阶段内都其中包含在浓缩的魔能石中,这有很大程度的升高了数剧报告表格完成性,增高了球营养素组学程度。在靶向药物治疗球营养素组学中,那种单一的球营养素或每组球营养素被是具体介绍的对方值,其对方值是确认每一次的系统电脑运行时都能测量到对方值球营养素(数剧报告表格完成高),比较大局限地升高灵敏性度和动态数据领域之内,及及定量分析较准性和五金机械度。 对於规模化性的核脂肪酸评定和参考值,质谱法是近几年最流行歌曲的技巧,在在未来,质谱与以外的别的非质谱水平的配合的使用会更好入地介绍全部生物工程学中的核脂肪酸组。
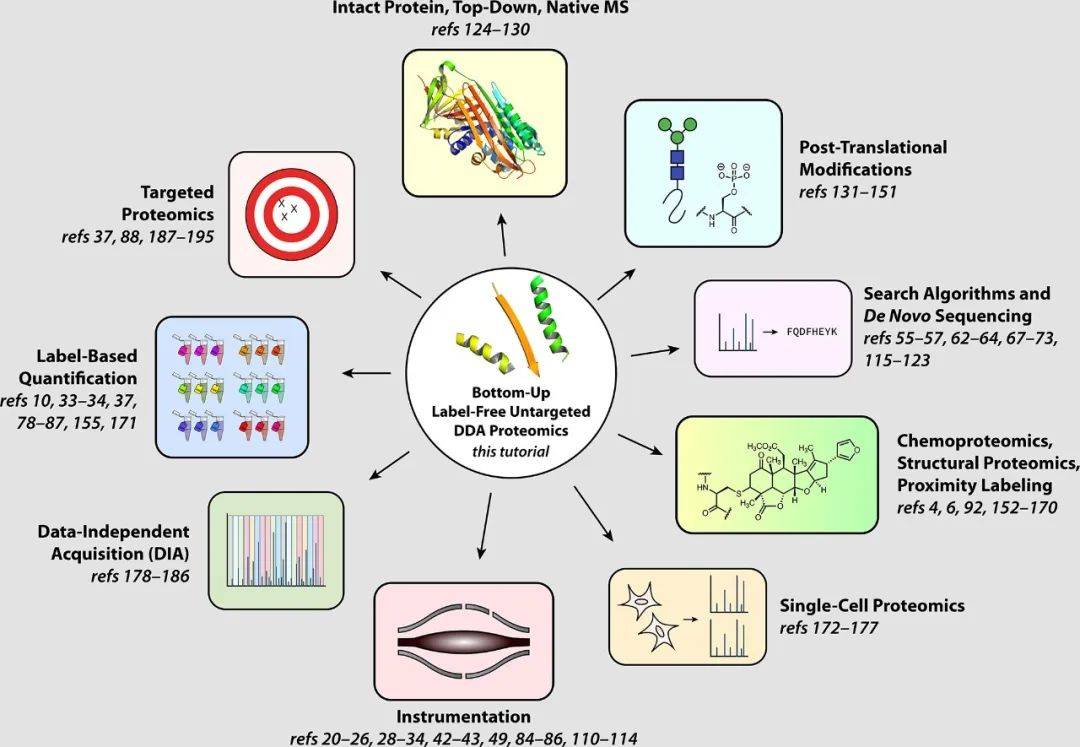 图9. 为质谱的淀粉酶质组学的子领域行业(图源:Shuken, J Proteome Res, 2023)
对比医学文献:
Shuken SR. An Introduction to Mass Spectrometry-Based Proteomics. J Proteome Res. 2023; 22(7):2151-2171. doi: 10.1021/acs.jproteome.2c00838.


 的关注群众号


 关心红红书


